
Indicizzare i Blob Storage con Azure Search
Nel mondo cloud di Microsoft i blob di Azure Storage sono lo strumento principale da usare per depositare file in modo sicuro, affidabile e scalabile. Si accedono via REST e con qualsiasi linguaggio, hanno uno spazio infinito (o quasi) e sono ampiamenti sfruttati dall'infrastruttura stessa.
Sulla stessa piattaforma, Azure Search è invece lo strumento dedicato ad indicizzare e offrire API REST per effettuare ricerche, suggerire e categorizzare documenti in senso lato. Entrambi gli strumenti possono essere usati congiuntamente perché non solo Azure Search è in grado di ricevere contenuti con uno schema da noi indicato, ma anche disporre di indexer che vadano a pescare contenuti dai blob stessi. Il motore è in grado infatti di indicizzare i contenuti di file come PDF, DOCX, XSLX, ZIP, XML e HTML, per citarne alcuni, e catturarne i metadati principali, come il titolo, l'autore e la lingua.
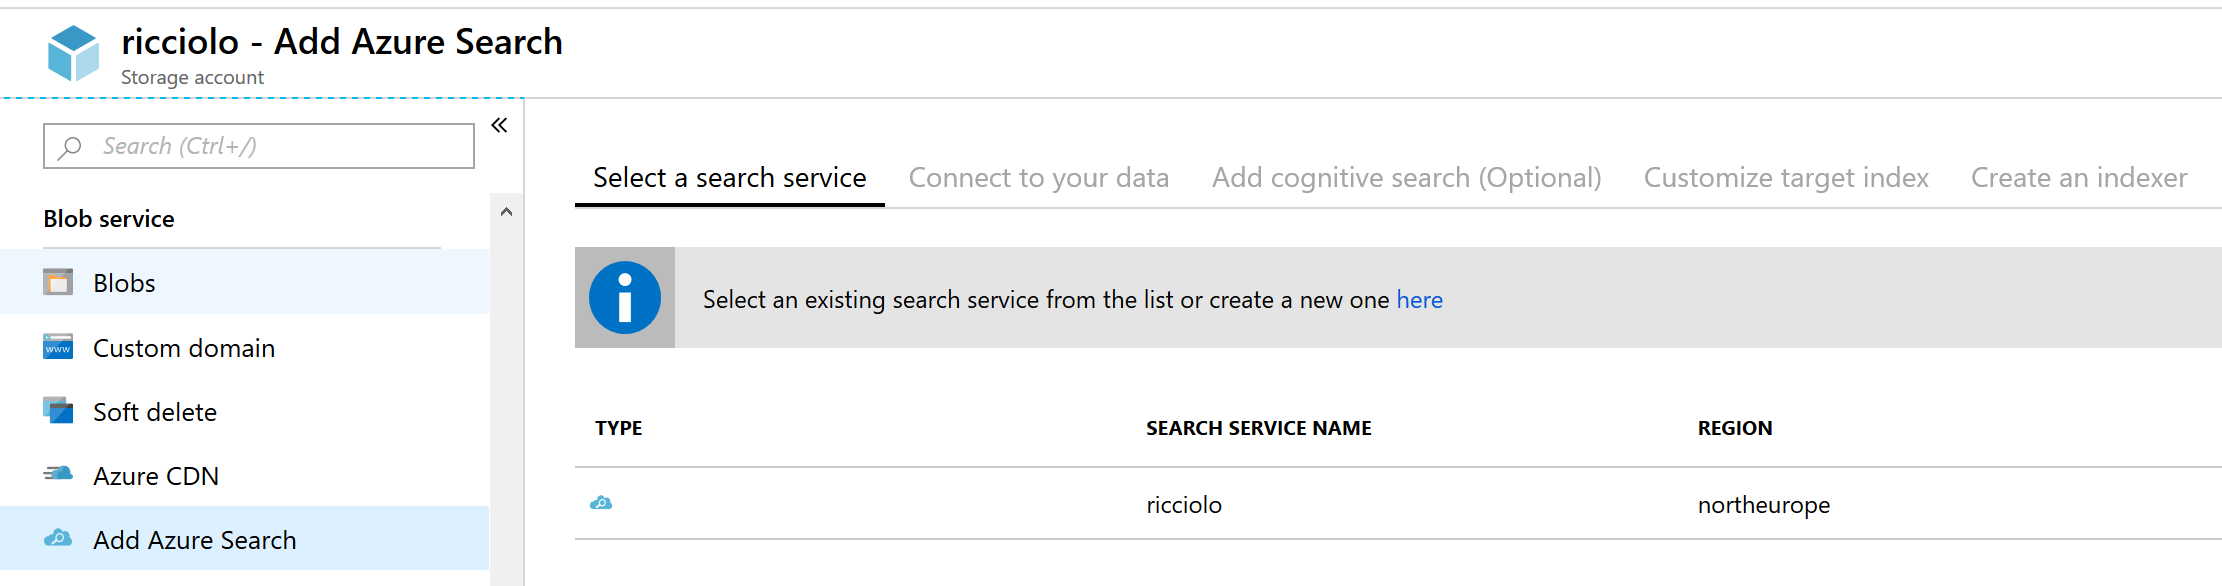
Collegare uno storage alla ricerca è ancora più facile. E' sufficiente recarsi sullo storage di riferimento e accedere alla sezione Add Azure Search. Ci viene proposto il servizio di Search da collegare, che deve già esistere.
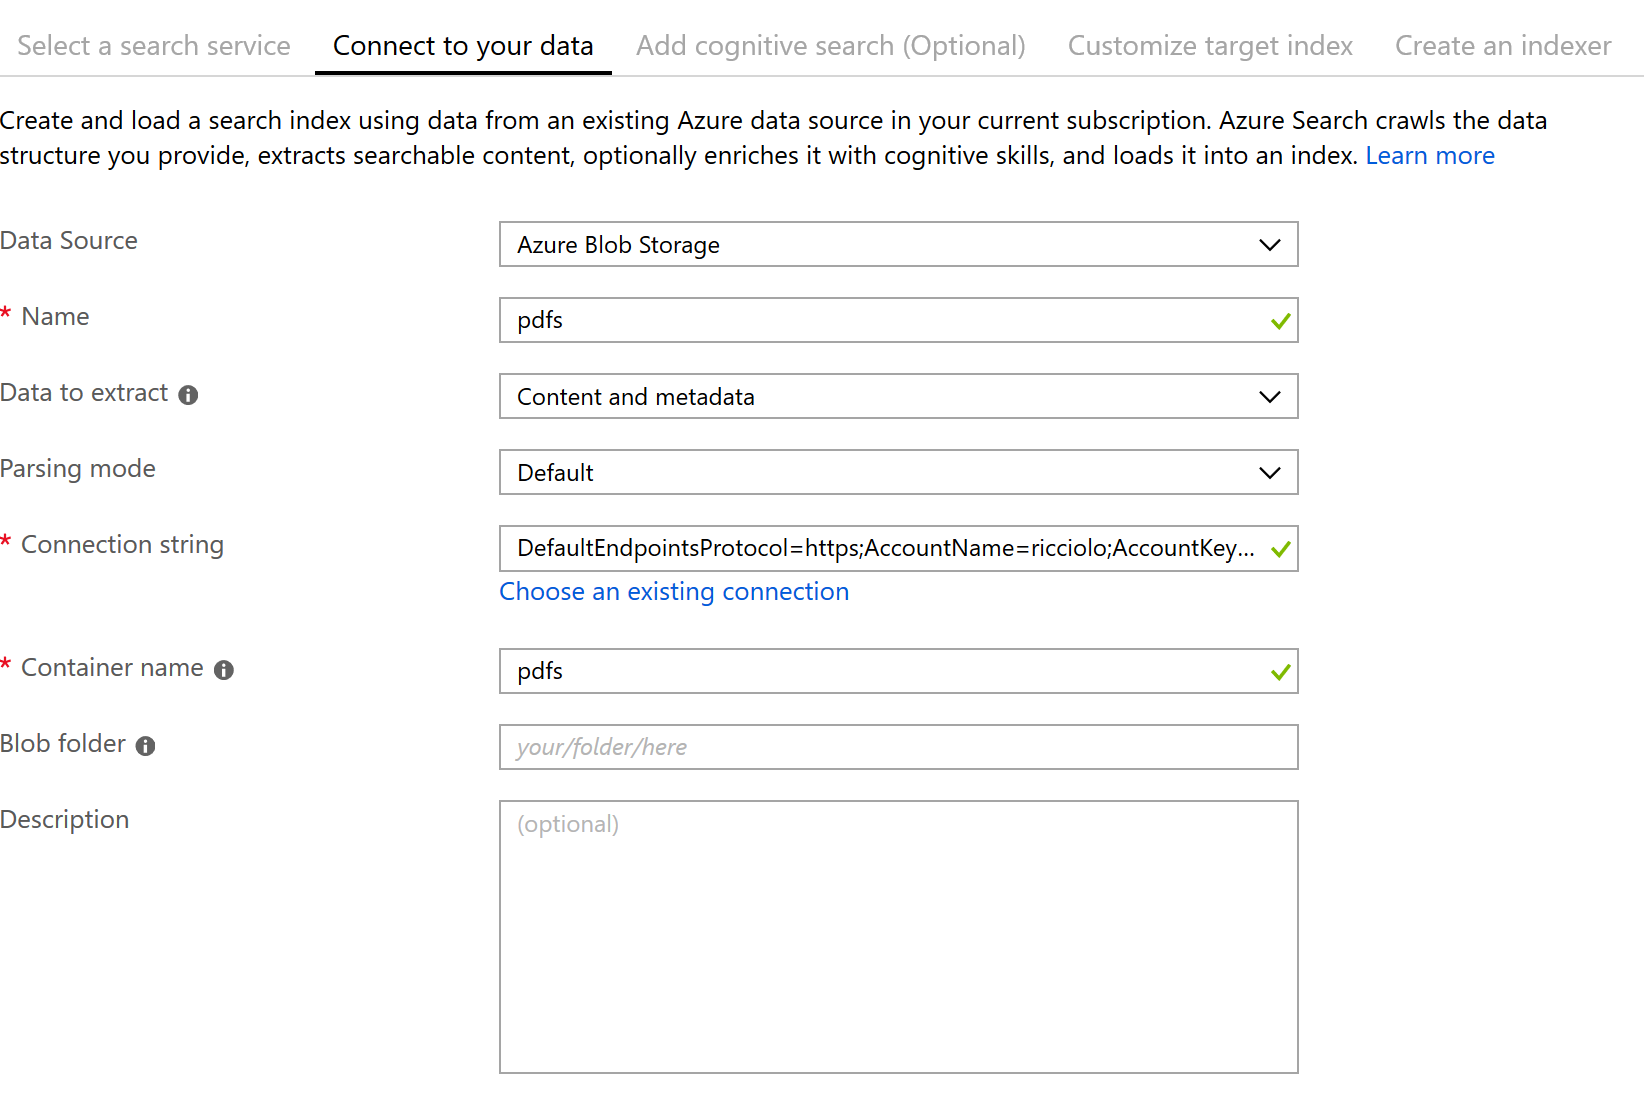
Il wizard ci porta poi a selezionare lo storage e il container da indicizzare, eventualmente filtrando per cartella. Possiamo decidere se indicizzare solo i metadati o anche il contenuto. Se siamo certi del tipo di file possiamo indicare anche il parsing mode, su JSON o Plain text, altrimenti lasciamo il default che lascia il compito al motore di capire il tipo di parser più adatto.
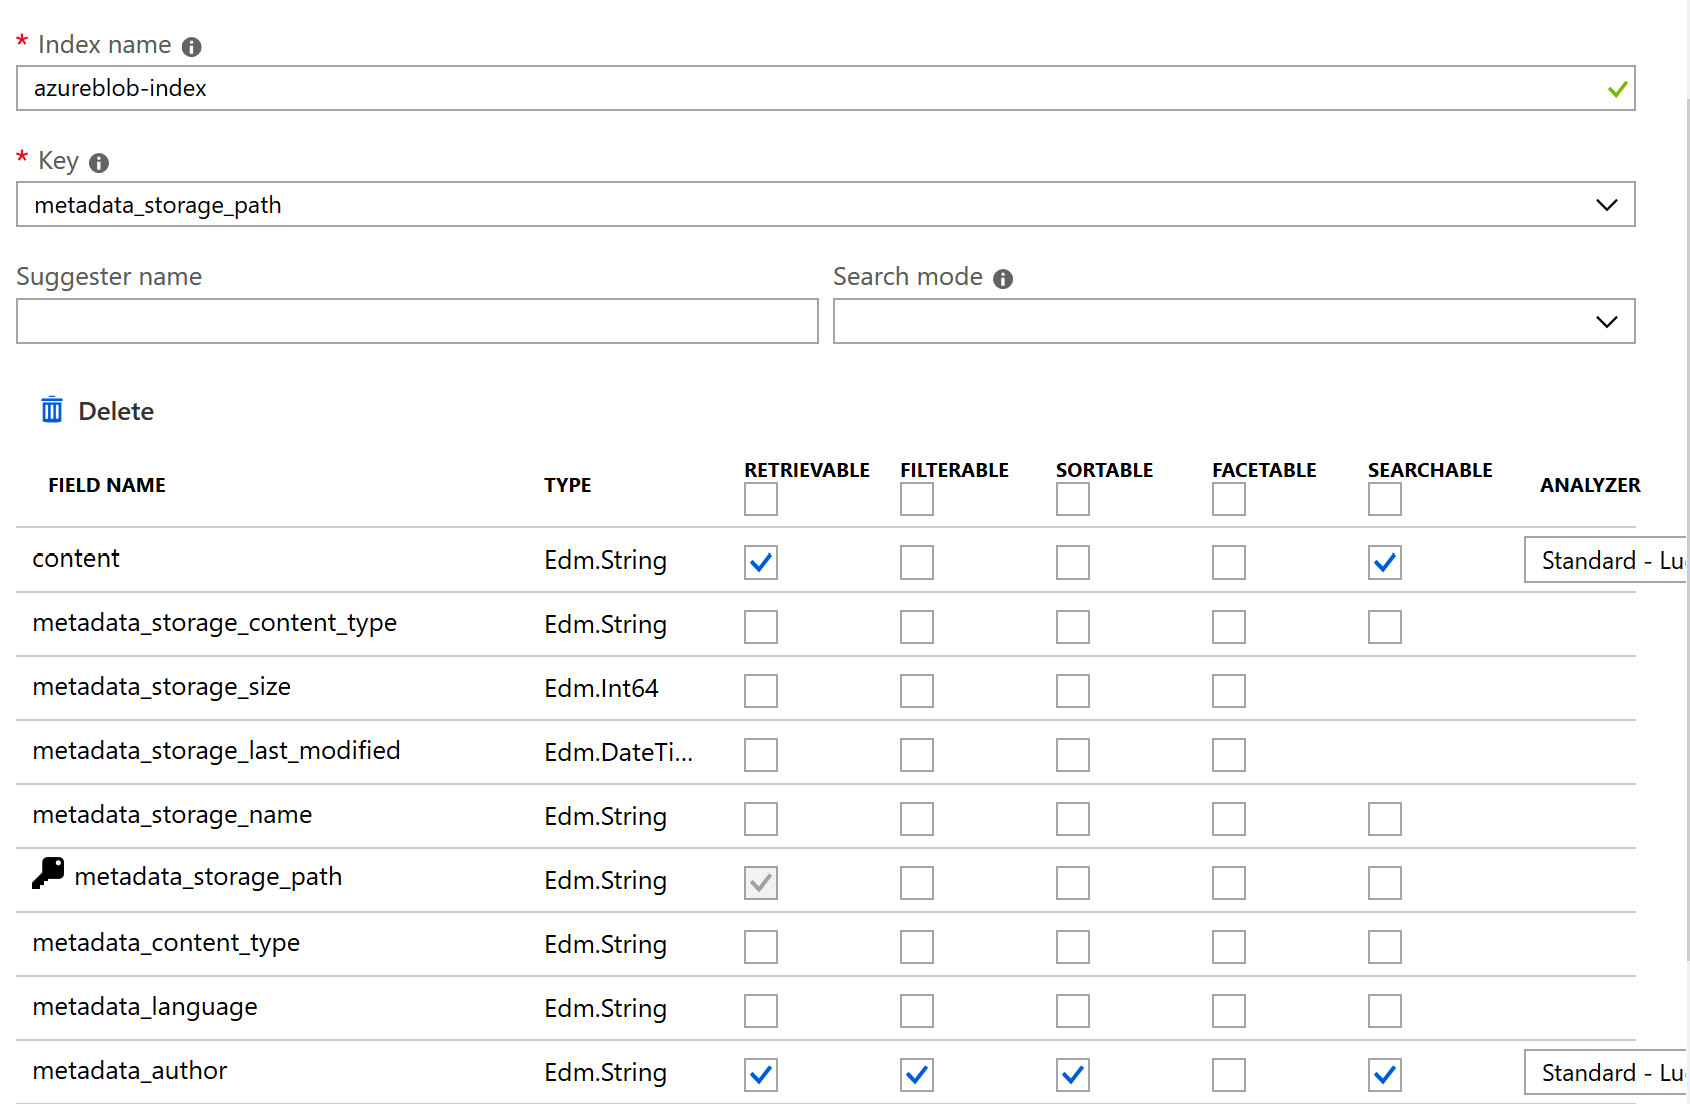
Dopo un'analisi del container, il quale deve obbligatoriamente avere uno o più file campione, ci viene proposto il tipo di indice che verrà creato: il nome, la chiave di riferimento (il path del blob) e i cambi individuati con il tipo di operazione che vogliamo supportare.
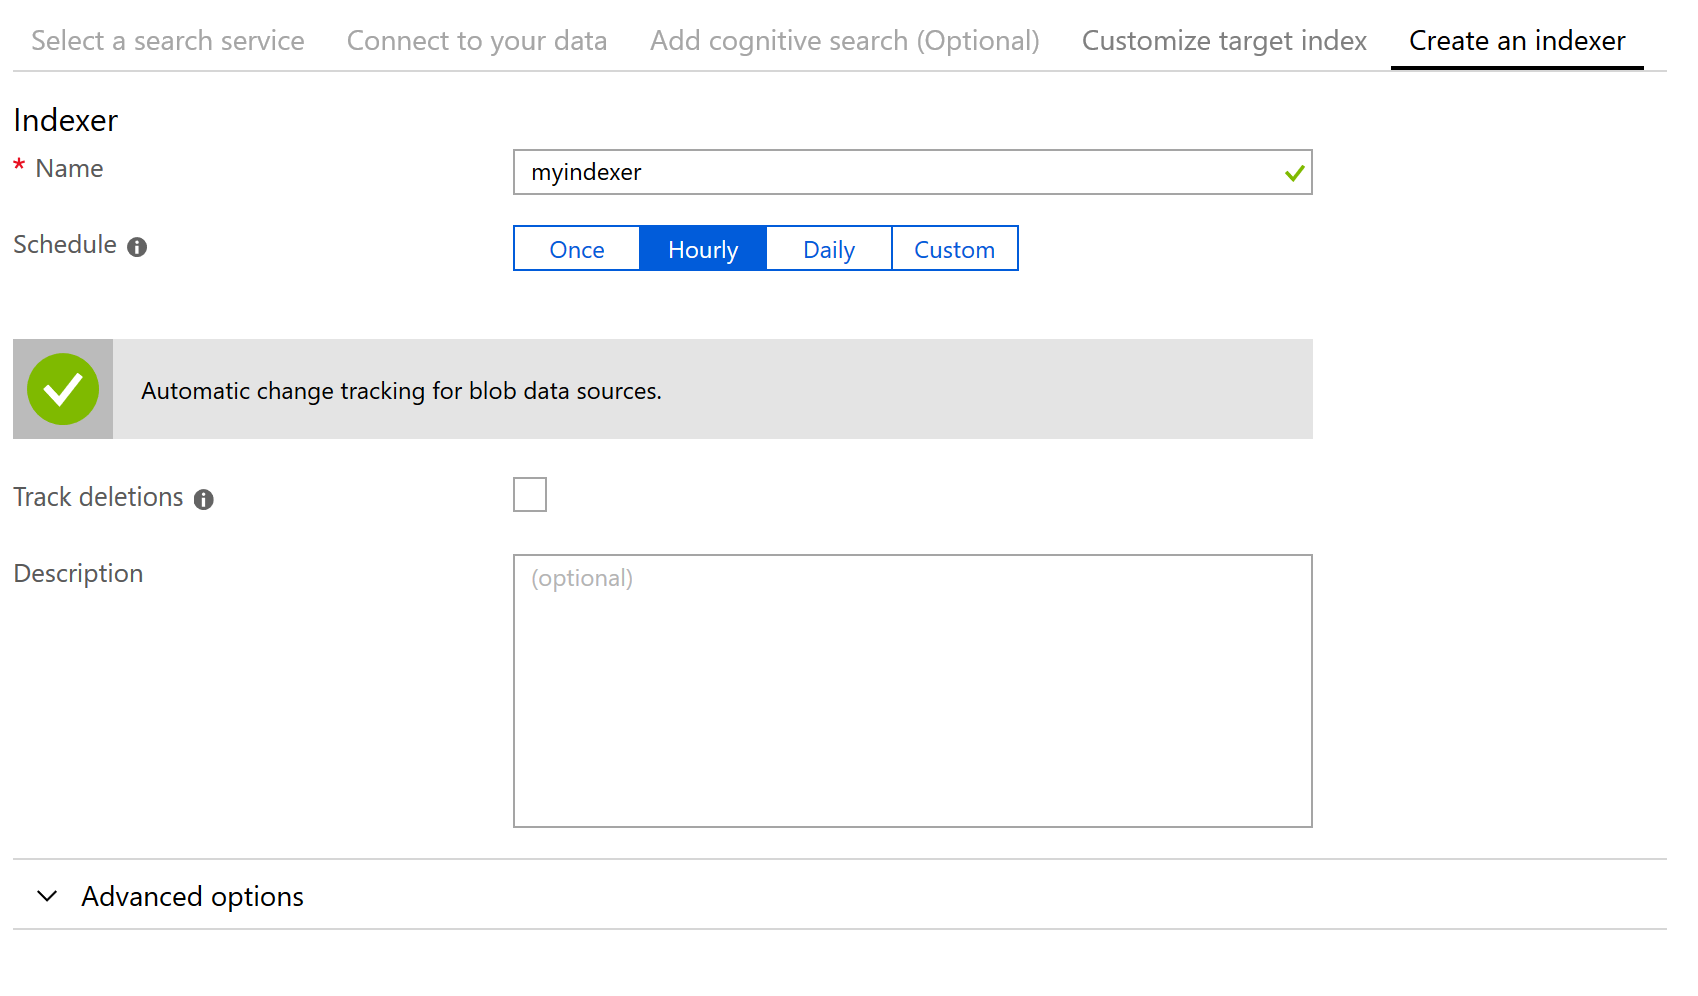
Come ultimo step dobbiamo configurare l'indexer, cioè con quale frequenza indicizzare i nuovi blob o quelli cambiati, operazione effettuata tramite il LastModifiedDate del blob.
Fatta quest'ultima operazione non ci resta che andare nella sezione Azure Search e vedere che sono stati creati un index, un indexer e un data source. Possiamo procedere a più indexer per ottenere più potenza e partizionare i documenti da processare.
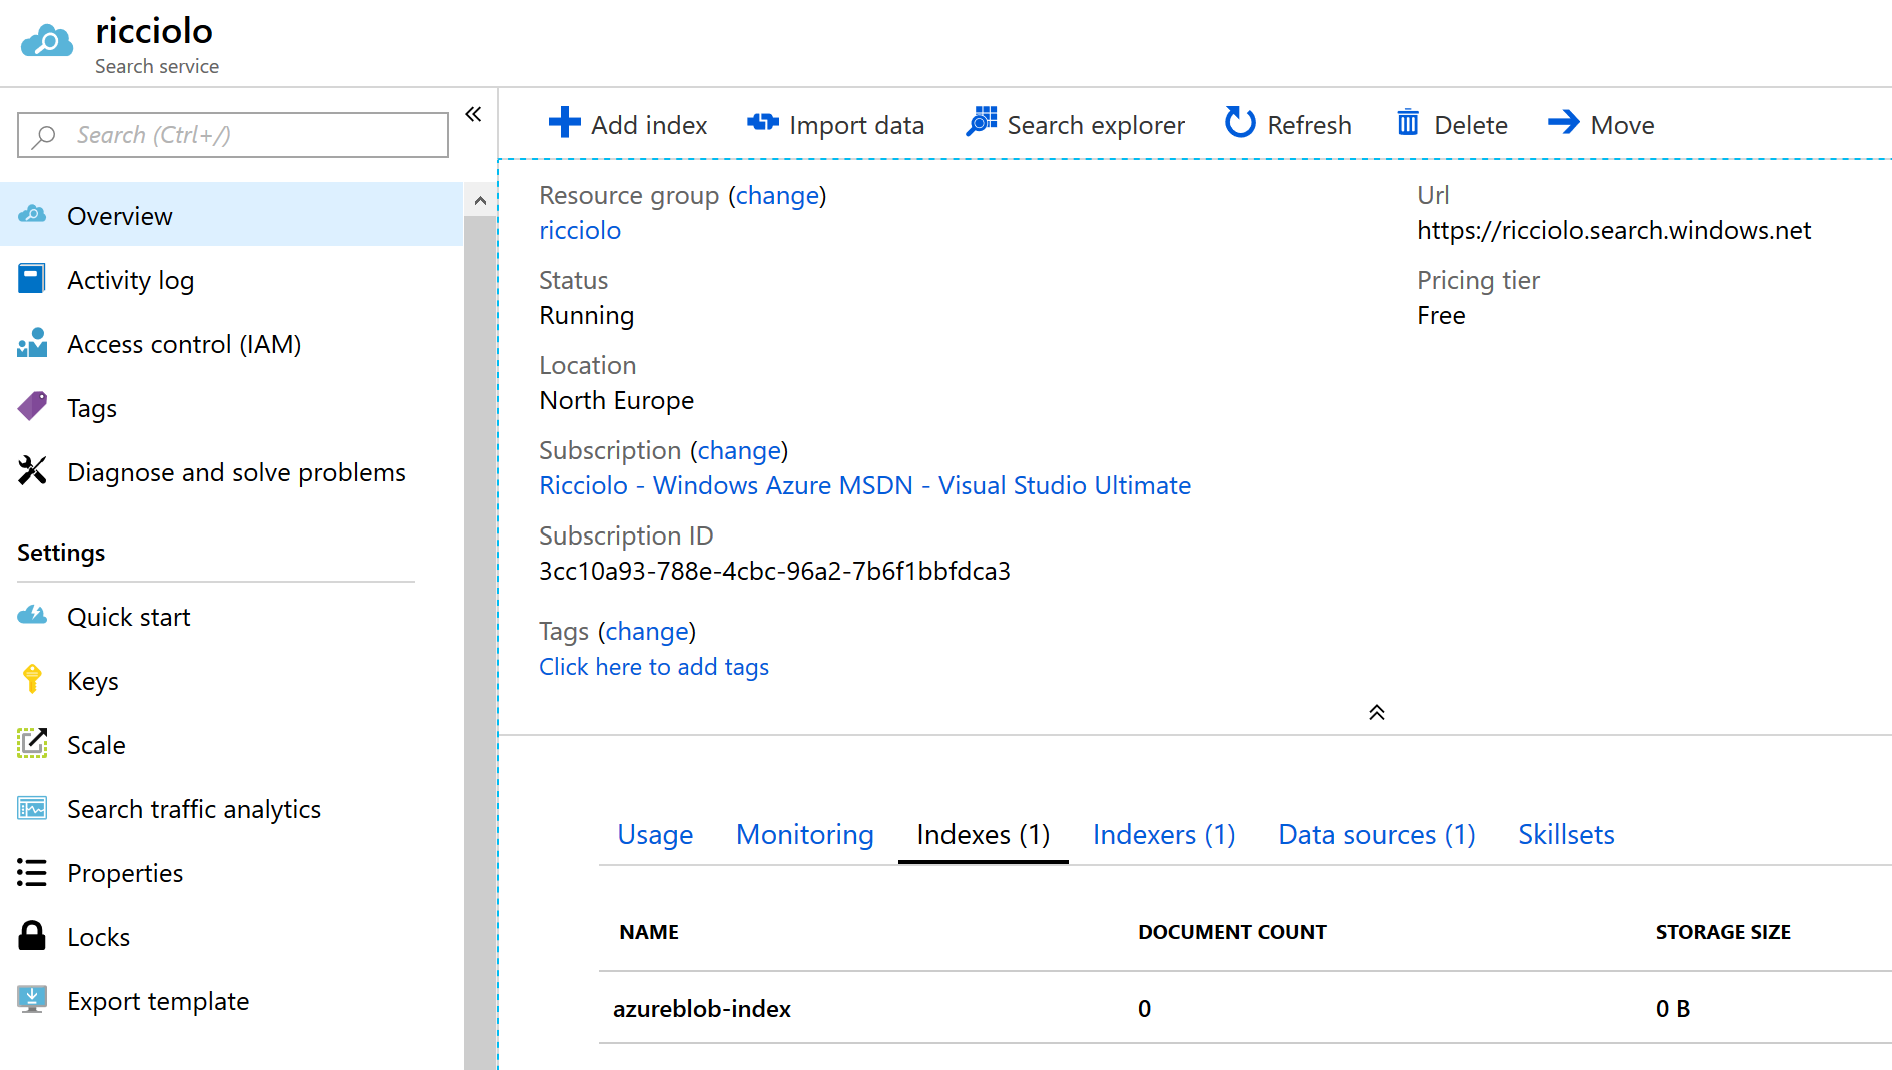
Premendo sull'indexer possiamo forzare l'esecuzione del motore, mentre accedendo all'index possiamo procedere ad un'interrogazione dell'indice.
Commenti

Per inserire un commento, devi avere un account.
Fai il login e torna a questa pagina, oppure registrati alla nostra community.
Approfondimenti
Eseguire una ExecuteUpdateAsync senza usare un'expression con Entity Framework
Filtrare i dati in ASP.NET Core usando OpenTelemetry su Azure Monitor
Gestione opzioni colonna nella Blazor QuickGrid
Integrare email esterne con Azure Functions e Managed Connectors
Raggruppare risorse in .NET Aspire
Ottimizzare i costi con Smart tier in Azure Blob Storage
Semplificare la gestione dei modelli con Azure AI Foundry Model Router
Cache temporanea in Javascript con oggetti
Creare una file based app con C#
Integrare LLM alle nostre applicazioni in .NET con MCP
Integrare OpenTelemetry direttamente in Azure Monitor
Operazioni tra insiemi di array in Javascript

